Why
為什麼做
策略網路每 0.217 秒才決策一次,Boss 很多閃避和槍反窗口卻只有 0.1–0.2 秒;而且模型只看得到自己打過的畫面,學不到「換個打法會怎樣」。我想找一個真實環境,把 RL、模仿學習和評估方法一起跑通。
What I built
我做了什麼
- 唯讀記憶體觀測加虛擬手把輸入:離線單機,不改血量也不改傷害,AI 跟人用一模一樣的按鍵打。
- MaskablePPO 策略網路:5,539 維狀態(位置、朝向、地形距離、招式剩餘時間、判定窗倒數、資源),14 種動作。
- 60 Hz 反射執行緒:預測落雷射線與投擲物,只在角色雙手空著時接手 0.22 秒。
- 可熱重載的 action masking 規則:只擋掉明顯送命的按鍵,選擇權一樣留給網路。
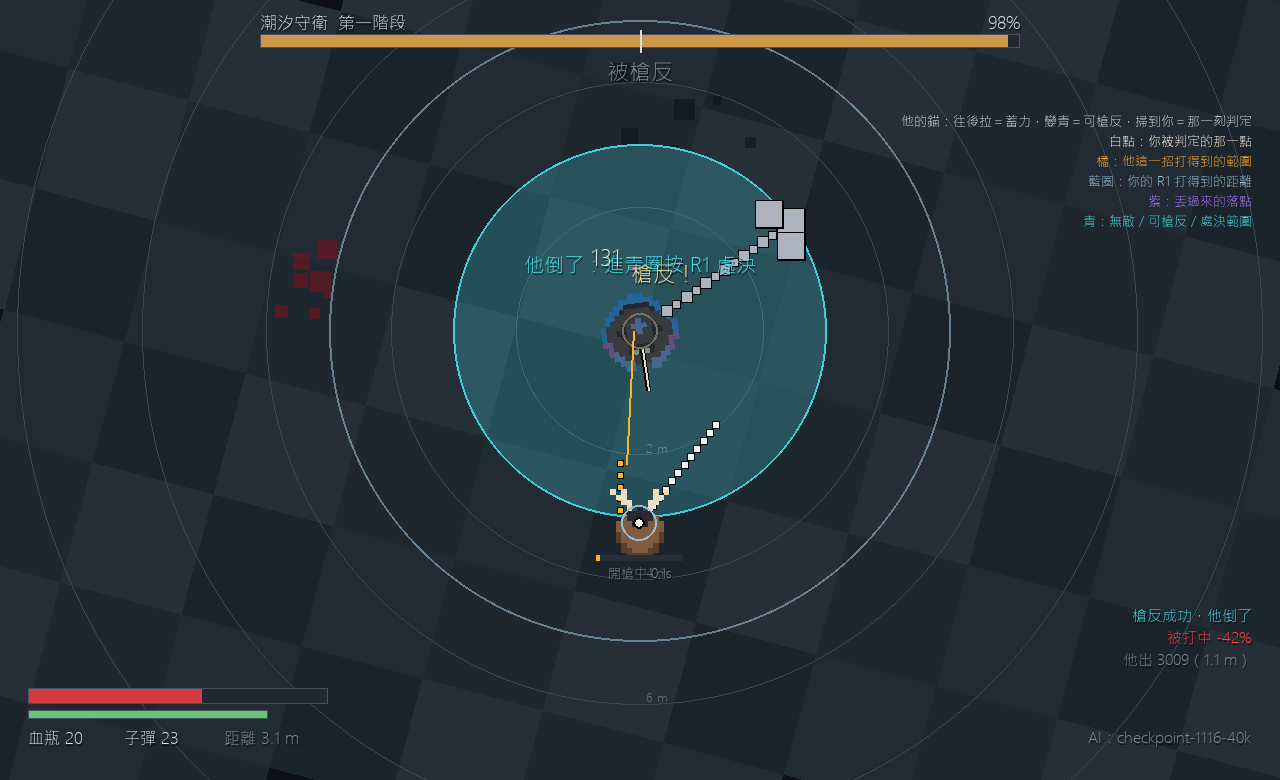
- 60 Hz 模擬道場:從反編譯腳本還原 Boss AI,自己可以進去打、看 AI 打,也能開加速訓練。
- 一輸就停的檢討工具:死掉自動暫停遊戲,整理死前幾秒的出招、反射觸發和距離。
Engineering
我碰到的工程問題
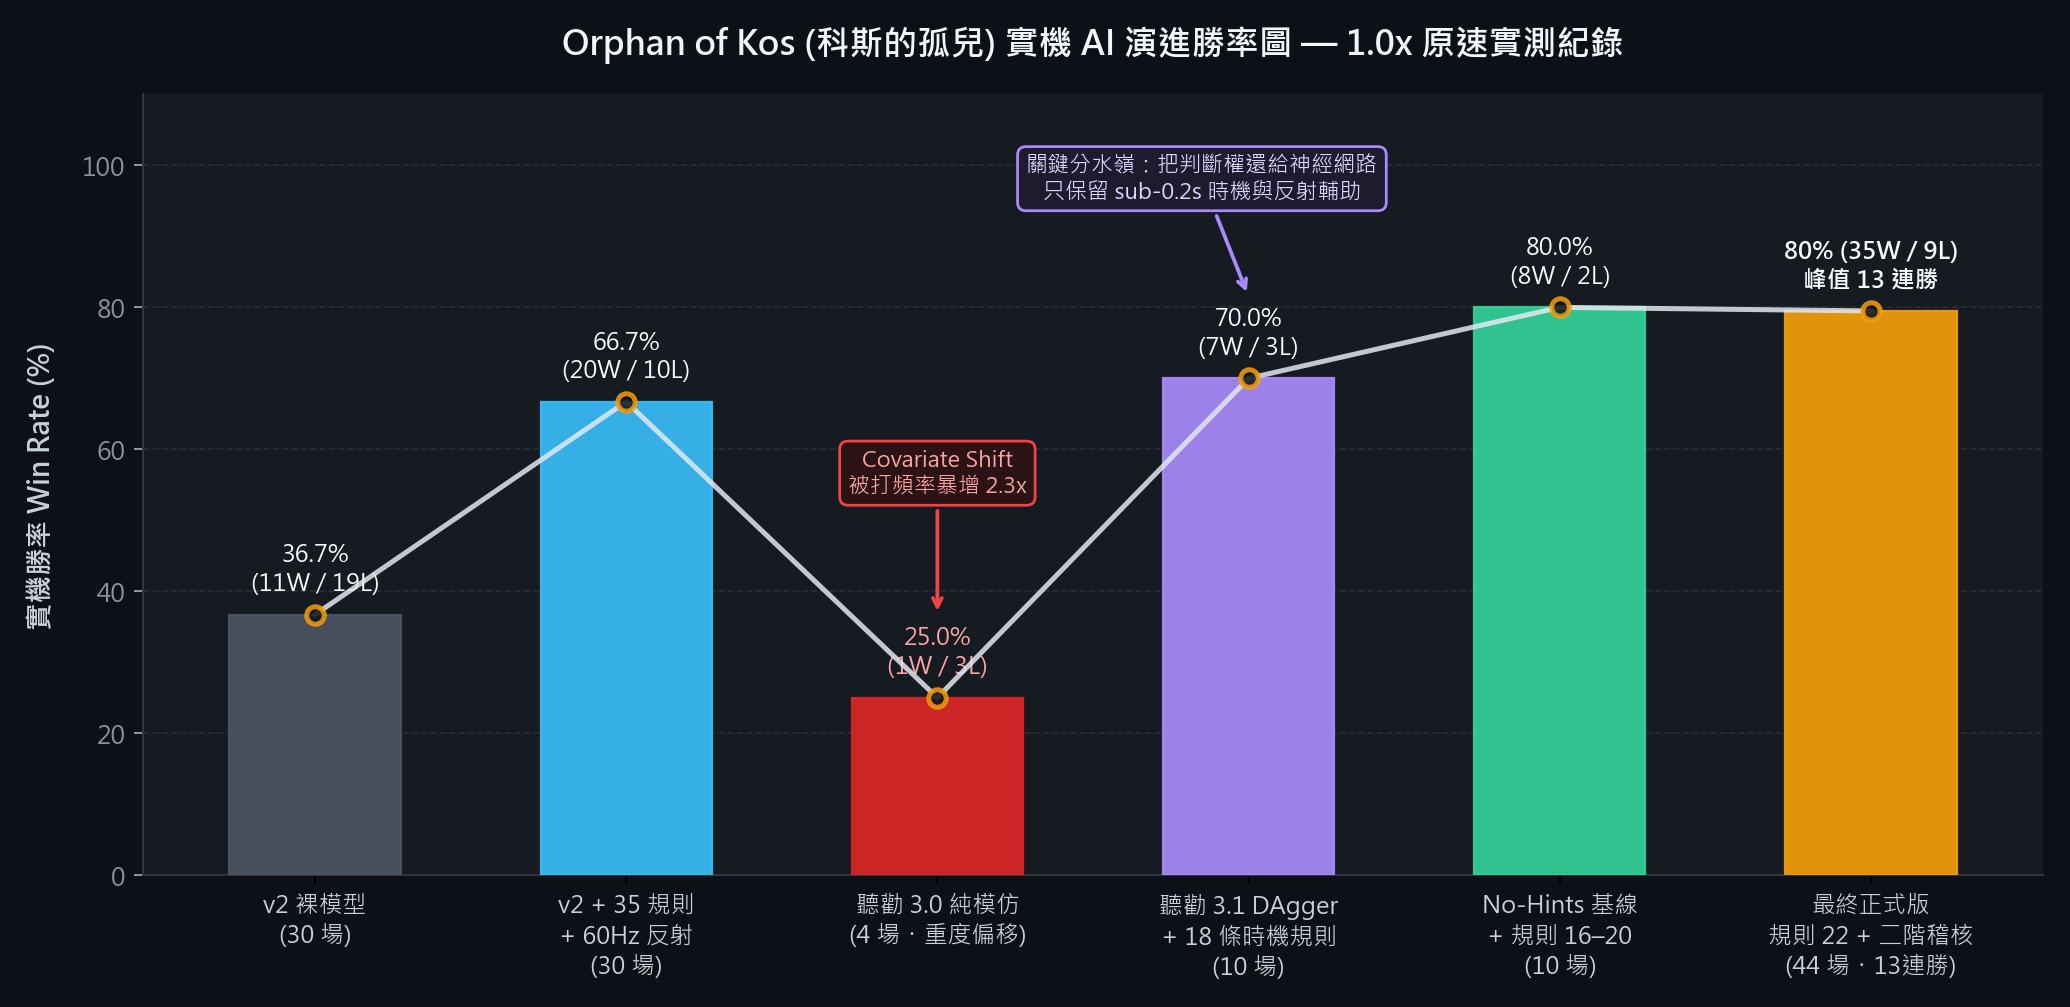
- Covariate shift:拿「模型 + 35 條規則」的 80 場錄影直接做行為克隆,離線 loss 一直降,上實機被打頻率反而暴增到 2.3 倍,4 場只贏 1 場。改用 DAgger 後走位與喝藥進了權重,只留人類反應不過來的 0.2 秒內時機規則,勝率回到 70%。
- 跨 Boss 遷移學習:聖職者野獸 → 加斯科因神父 → 瑪利亞 → 孤兒,約 95% 權重直接沿用(4,980 / 5,222)。
- 歷史紀錄看不出「當時換個打法會怎樣」:逐場補死因進步有限,後來把玩家觀念「一階段別讓 Boss 貼身」寫成規則,再逐招稽核二階段,勝率上到 80%。
- 改動一律用整段連續場次的勝率,搭配信賴區間與連敗機率評估,不看單場輸贏下結論。
Role & AI
我和 AI 怎麼分工
目標、操作限制與驗收標準全由我定,打輸了就重看錄影、追每一場的細節紀錄。Claude Code、Codex 與 Gemini 一起參與程式碼、審查和模擬道場;最後留哪個版本、哪個死因該補觀測還是重訓,由我拍板。
Trade-offs
實測後推翻與取捨
- 策略主體跑在約 4.6 Hz,遇到 0.2 秒內的閃避/槍反窗就交給 60 Hz 反射層接手,把訓練重心與穩定度留給走位和大方向決策。
- 曾把提示表換成更精確的版本卻沒跟著重訓,實機直接掉到 4 勝 10 敗——改觀測同樣會打亂模型原本熟悉的輸入分布。
- 道場裡一面放錯位置的牆曾把模型教成一路後退;模擬器能加速實驗,地形和走位還是得回實機確認。
Outcome
成果
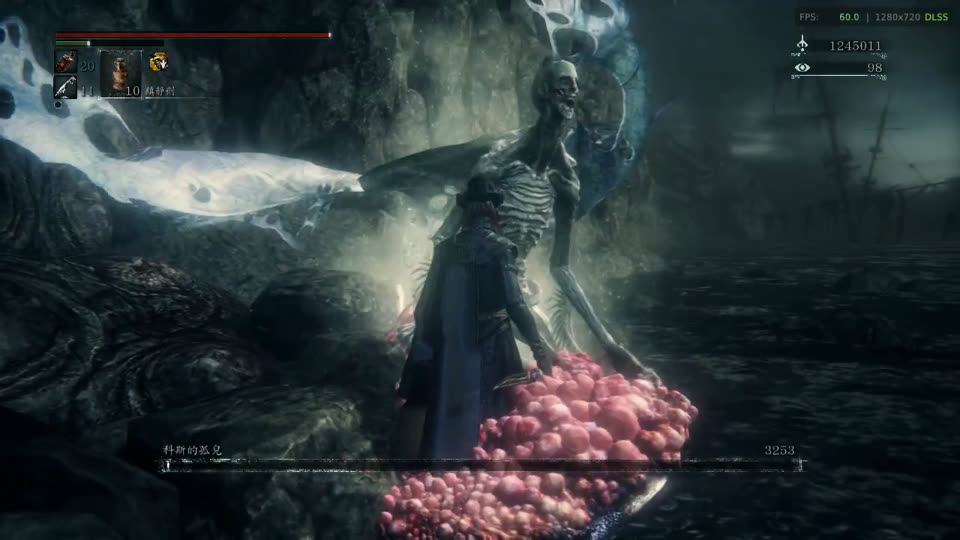
混合架構版本在原速實機打出 44 場 35 勝、最長 13 連勝(附逐場紀錄);後續也拆開做純 RL、威脅雷達與模擬道場實驗,持續把更多判斷交回模型。